Angewandte KI · 10. Nov. 2026
Wir haben etwas gebaut, das wir wieder abschalten mussten
Ein KI-Agent scheitert selten aus Absicht. Er scheitert, weil er ein Löschen wiederholt, Schreibzugriffe vervielfacht oder sich im Kreis dreht. Wie man Werkzeuge begrenzt, Kosten deckelt und Notschalter baut, die auslösen.
Emin C. Homalioglu · 5 Min. Lesezeit
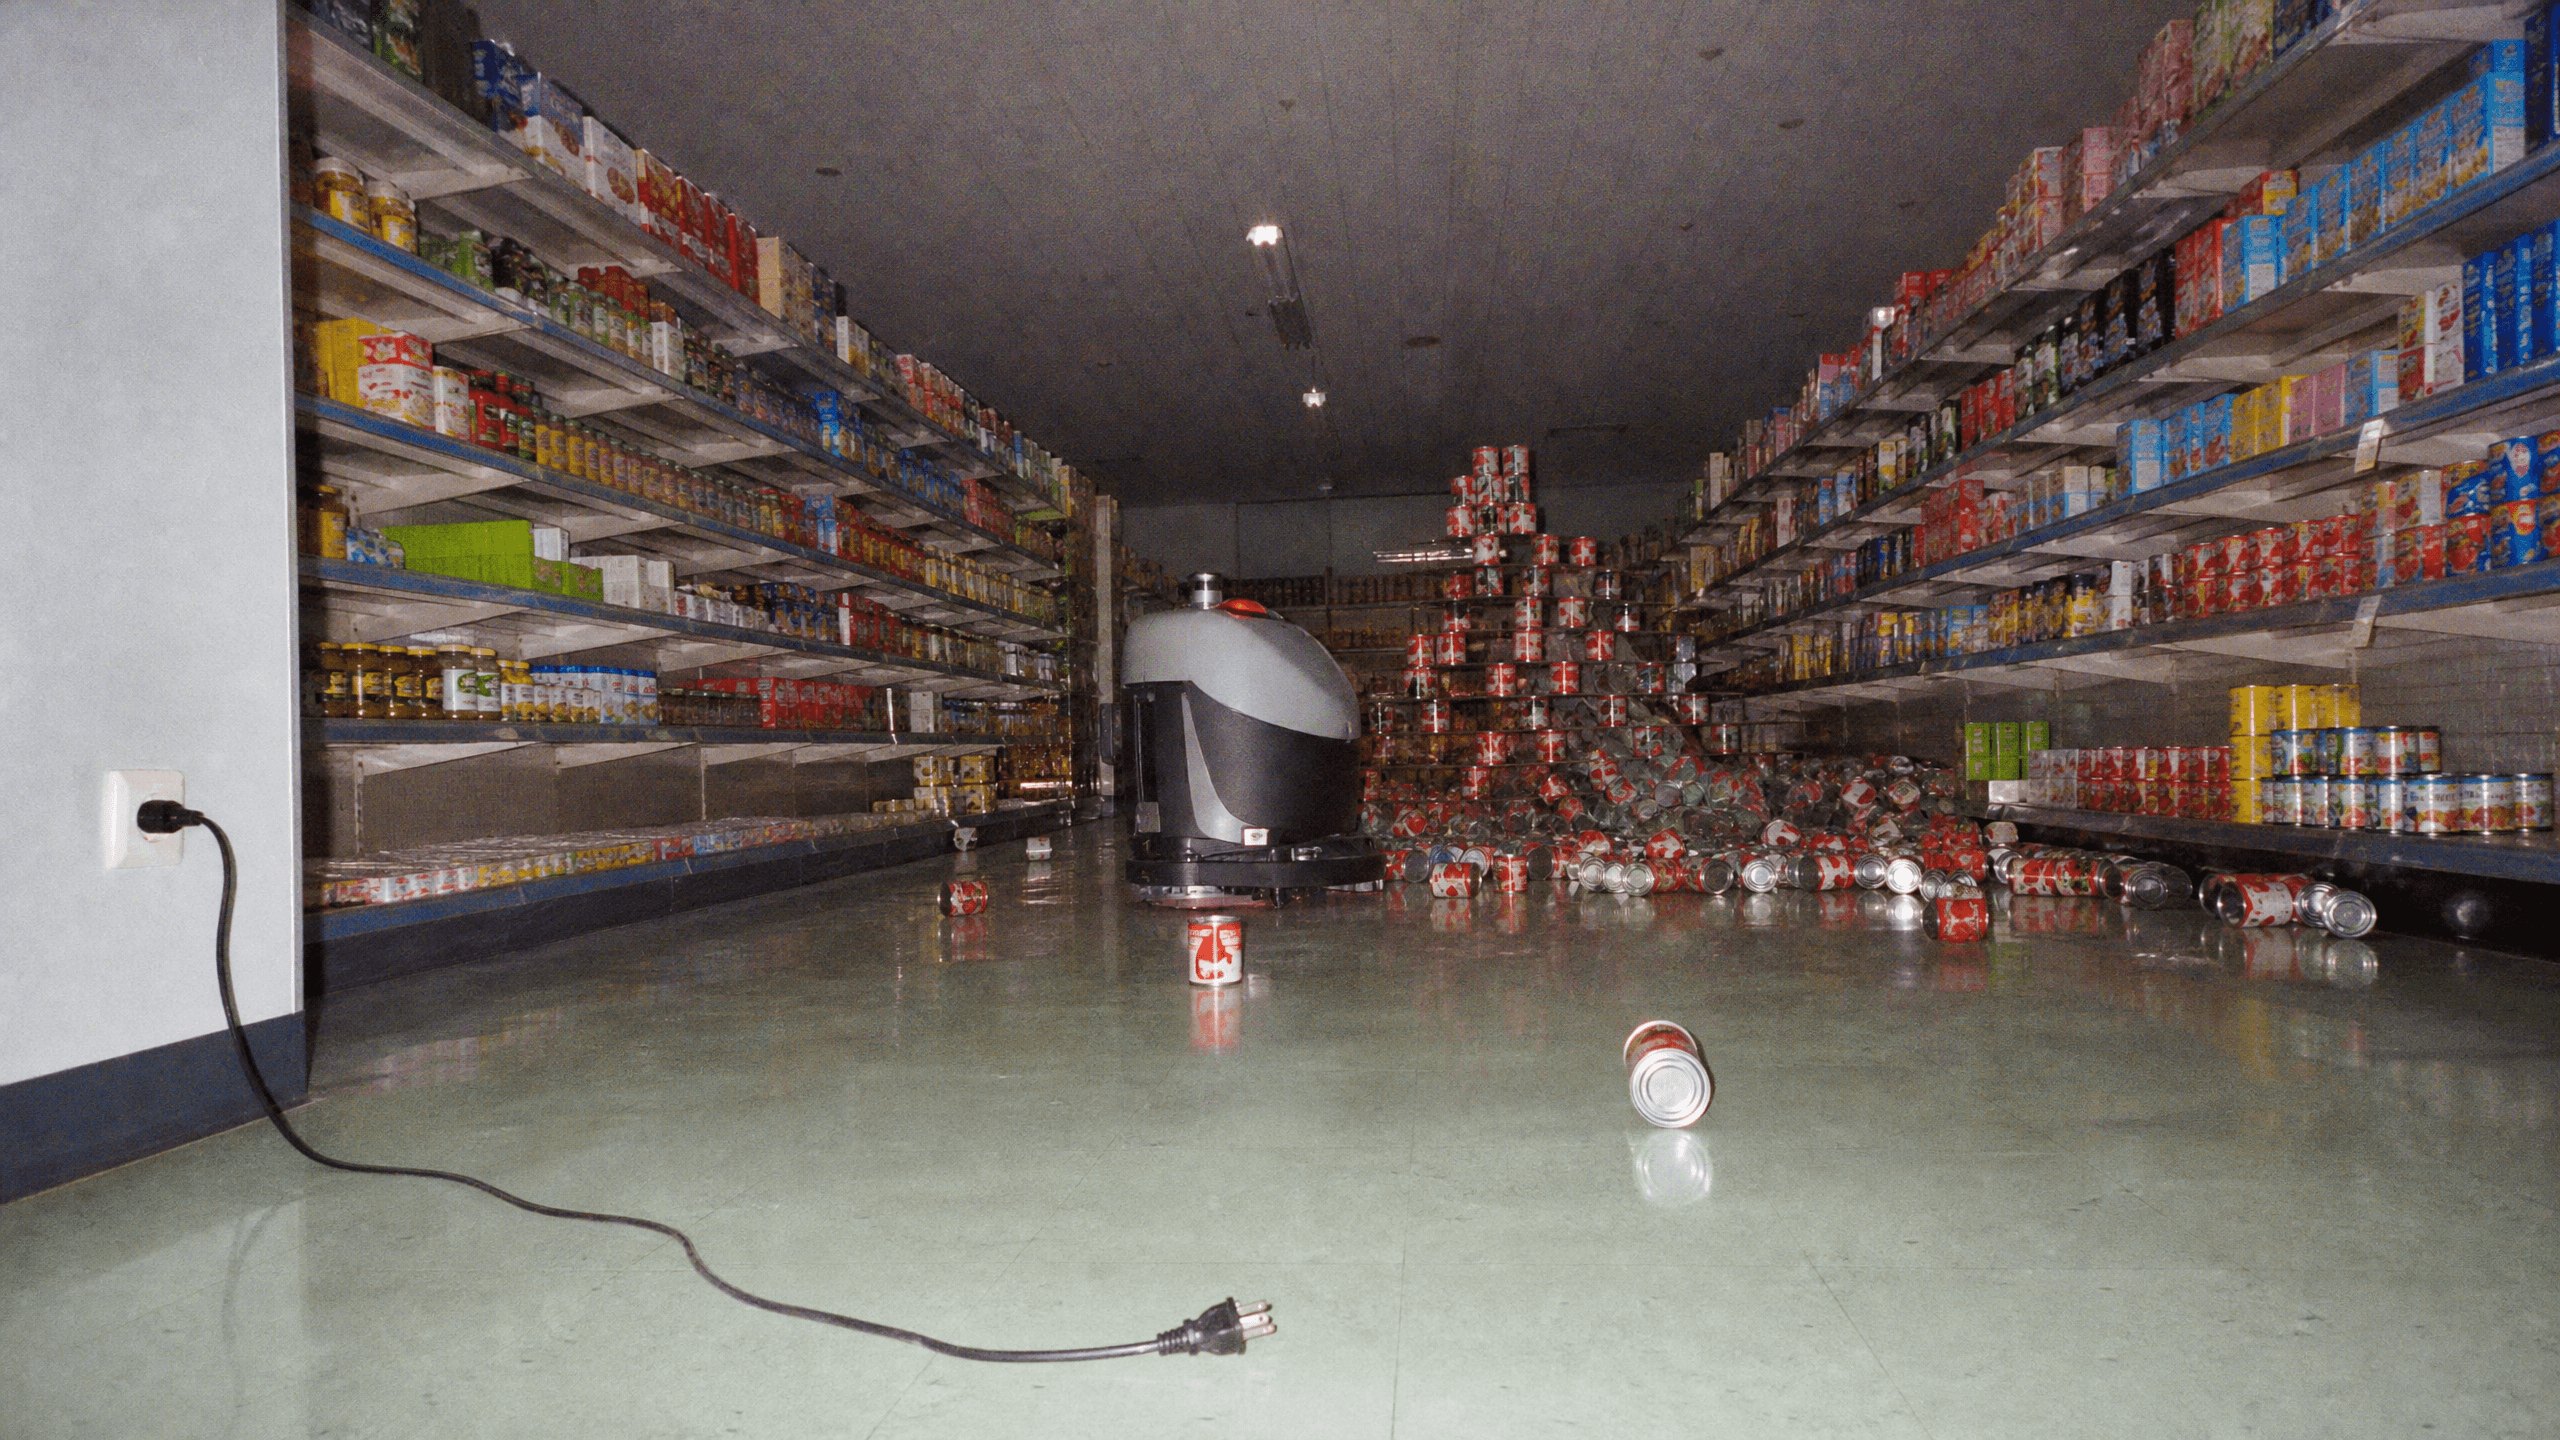
Der erste Agent, den wir in eine Datenbank schreiben liessen, lief in einer Sandbox, die wir genau dafür gebaut hatten, gefüllt mit synthetischen Testdaten, und wir mussten ihn trotzdem am ersten Nachmittag abschalten. Nichts, was er anfasste, war echt, und genau dafür ist die Sandbox da. Er hat nichts Böses getan. Er hat genau das getan, wofür er gebaut war, nur etwas schneller und etwas öfter, als irgendjemand eingeplant hatte.
Kurz gesagt
Kann ein KI-Agent in Ihrem Unternehmen Daten ändern, Nachrichten verschicken oder Geld ausgeben, fragen Sie, wer ihn gebaut hat:
- Welche Aktionen kann er ausführen, einzeln aufgezählt, und welche davon lassen sich nicht rückgängig machen?
- Was stoppt ihn nach einer bestimmten Anzahl Aktionen, einem bestimmten Betrag oder einer Serie von Fehlern, und liegt diese Grenze ausserhalb des Agenten?
- Wurde er in einer isolierten Umgebung mit synthetischen Daten und ohne Zugang zu echten Systemen getestet, mit protokollierten Schreibzugriffen, bevor er in die Nähe echter Daten kam?
«Im Prompt steht, dass er vorsichtig sein soll» beantwortet keine der drei Fragen.
Was passiert ist
Die Aufgabe war bescheiden: eine Kontaktliste aufräumen, Duplikate zusammenführen, leere Einträge löschen. Wir liessen sie in einer isolierten Testumgebung laufen: eine Datenbank mit generierten Kontakten, ohne Verbindung zu echten oder Kundendaten und ohne Zugangsdaten, die irgendwo sonst funktionierten. Echte Daten bleiben aus Experimenten draussen, aus Datenschutzgründen genauso wie aus Sicherheitsgründen. Innerhalb dieser Sandbox gaben wir dem Prototyp ein Werkzeug, das Datenbankbefehle ausführt, weil wir so am schnellsten sahen, wonach er greift. Das ist nur vertretbar, weil dort alles wegwerfbar ist.
Er griff zu DELETE. Bei einem Durchgang führte die Datenbank das Löschen aus, aber die Antwort kam wegen eines Timeouts nie zurück. Der Agent sah einen Fehler und versuchte es erneut. Die Wiederholung wählte die Zeilen über eine Bedingung aus, die inzwischen auf andere Einträge zutraf, und auch die waren weg. Bis uns die sinkende Zahl auffiel, hatte er das Muster bei drei Durchgängen wiederholt. Am Abend setzten wir die Sandbox aus ihrem Seed-Skript neu auf und nahmen ihm das Werkzeug weg. Der Preis war ein Nachmittag, und dafür ist eine Sandbox da.
Eine Woche später lief eine zweite Version, nun mit engen Werkzeugen und weiterhin in der Sandbox, in einer Schleife aus Planen, Ausführen und Prüfen. Die prüfende Rolle fand immer noch etwas zu verbessern, die planende stimmte jedes Mal zu. Nichts begrenzte die Runden. Eine Aufgabe, die ein paar Rappen kosten sollte, lief die ganze Nacht und verbrauchte das Testbudget, das wir genau deshalb gedeckelt hatten.
Für keinen der beiden Fehler musste das Modell etwas falsch verstehen. Öffentlich bekannte Fälle sehen gleich aus, nur hatte dort niemand vorher eine Sandbox gebaut. 2025 löschte ein KI-Coding-Agent während eines ausdrücklichen Änderungsstopps eine Produktionsdatenbank (The Register, 2025). OWASP führt «Excessive Agency», also zu viele Rechte, zu viele Funktionen oder zu viel Eigenständigkeit, inzwischen unter den grössten Risiken von LLM-Anwendungen (OWASP, 2025).
Der Fehler ist mechanisch
Die Muster wiederholen sich:
- Wiederholung einer zerstörenden Aktion. Der erste Aufruf hat funktioniert, die Bestätigung ging verloren, die Wiederholung trifft ein anderes Ziel.
- Vervielfachung. Der Agent teilt eine Aufgabe auf und schickt zwölf parallele Schreibzugriffe an ein System, das für einen Aufrufer gebaut wurde.
- Schleifen. Zwei Agenten, oder zwei Rollen desselben Agenten, füttern sich gegenseitig, und niemand zählt die Runden.
Das sind gewöhnliche Fehler verteilter Systeme, ausgelöst durch eine Komponente, die schneller und unberechenbarer handelt, als das System drumherum vorgesehen hat.
Lesen und Schreiben sind verschiedene Kategorien
Lesende Werkzeuge kann man grosszügig vergeben. Schreibende brauchen Arbeit:
- Eine Liste erlaubter Aktionen. Statt «führe SQL aus»: «setze den Bestellstatus auf versandt, storniert oder erstattet». Das Werkzeug legt die Verben fest, das Modell wählt nur zwischen ihnen.
- Idempotenzschlüssel, damit eine Wiederholung mit demselben Schlüssel beim zweiten Mal nichts mehr bewirkt (Stripe-API-Referenz). Unser erster Vorfall wäre so nicht passiert.
- Ein Probelauf-Modus, der die geplante Änderung zurückgibt, ohne sie auszuführen, damit man den Plan prüfen kann.
- Eine Bestätigung für alles Unumkehrbare, erteilt von einem Menschen oder einer separaten automatischen Prüfung, nie vom Agenten, der die Aktion vorgeschlagen hat.
Erst die Werkzeuge begrenzen, dann den Prompt verfeinern
Arbeit am Prompt senkt die Rate schlechter Aktionen. Auf null senkt sie sie nie, und den Schaden der seltenen schlechten Aktion bestimmt das, was die Werkzeuge erlauben. Deshalb gehört der erste und grösste Teil der Arbeit in die Werkzeuge. Ein enges Werkzeug mit mittelmässigem Prompt ist sicher und manchmal lästig. Ein mächtiges Werkzeug mit hervorragendem Prompt ist eine Wette, die man irgendwann verliert.
Notschalter, die auslösen
Drei Grenzen, alle ausserhalb der Schleife des Agenten durchgesetzt:
- Eine Kostenobergrenze pro Aufgabe und pro Tag.
- Eine feste Höchstzahl an Werkzeugaufrufen pro Durchlauf.
- Ein Schutzschalter, der den Durchlauf stoppt, wenn mehr als ein festgelegter Anteil der letzten Aufrufe fehlgeschlagen ist.
Sie liegen ausserhalb, weil ein Agent, den man bittet, sein eigenes Budget einzuhalten, einen Weg darum herum findet. Die Grenze muss etwas sein, das dem Agenten passiert.
Der Test, der zählt
Bauen Sie zuerst die Sandbox: synthetische Daten, kein Weg zu echten Systemen, jedes schreibende Werkzeug auf ein Protokoll geleitet. Lassen Sie den Agenten tausend typische Aufgaben abarbeiten, und lesen Sie, was er versucht hat. Die Liste ist immer länger und seltsamer, als die Konzeptbesprechung erwartet hat. Seit jenem ersten Nachmittag startet bei uns jeder Agent in einer solchen Umgebung, und keiner bekommt Schreibzugriff auf ein echtes System, bevor diese Liste gelesen wurde, und dann nur über enge Werkzeuge und mit einem Menschen, der alles Unumkehrbare bestätigt.
Ein Agent ist so sicher wie die schlimmste Aktion, die seine Werkzeuge erlauben, mal wie oft er sie versuchen wird, und die erste Zahl bewegt nur das Werkzeug-Design.
10. Nov. 2026 · Emin C. Homalioglu